池化技术想必大家已经屡见不鲜了,线程池、数据库连接池、HTTP 连接池等等都是对这个思想的应用。池化技术的思想主要是为了减少每次获取资源的消耗,提高对资源的利用率。
这篇文章我会详细介绍一下线程池的基本概念以及核心原理。
一、线程池介绍
池化技术想必大家已经屡见不鲜了,线程池、数据库连接池、HTTP 连接池等等都是对这个思想的应用。池化技术的思想主要是为了减少每次获取资源的消耗,提高对资源的利用率。
线程池提供了一种限制和管理资源(包括执行一个任务)的方式。 每个线程池还维护一些基本统计信息,例如已完成任务的数量。使用线程池主要带来以下几个好处:
- 降低资源消耗:线程池里的线程是可以重复利用的。一旦线程完成了某个任务,它不会立即销毁,而是回到池子里等待下一个任务。这就避免了频繁创建和销毁线程带来的开销。
- 提高响应速度:因为线程池里通常会维护一定数量的核心线程(或者说“常驻工人”),任务来了之后,可以直接交给这些已经存在的、空闲的线程去执行,省去了创建线程的时间,任务能够更快地得到处理。
- 提高线程的可管理性:线程池允许我们统一管理池中的线程。我们可以配置线程池的大小(核心线程数、最大线程数)、任务队列的类型和大小、拒绝策略等。这样就能控制并发线程的总量,防止资源耗尽,保证系统的稳定性。同时,线程池通常也提供了监控接口,方便我们了解线程池的运行状态(比如有多少活跃线程、多少任务在排队等),便于调优。
二、Executor 框架介绍
Executor 框架是 Java5 之后引进的,在 Java 5 之后,通过 Executor 来启动线程比使用 Thread 的 start 方法更好,除了更易管理,效率更好(用线程池实现,节约开销)外,还有关键的一点:有助于避免 this 逃逸问题。
this 逃逸是指在构造函数返回之前其他线程就持有该对象的引用,调用尚未构造完全的对象的方法可能引发令人疑惑的错误。
Executor 框架不仅包括了线程池的管理,还提供了线程工厂、队列以及拒绝策略等,Executor 框架让并发编程变得更加简单。
Executor 框架结构主要由三大部分组成:
1、任务(Runnable /Callable)
执行任务需要实现的 Runnable 接口 或 Callable接口。Runnable 接口或 Callable 接口 实现类都可以被 ThreadPoolExecutor 或 ScheduledThreadPoolExecutor 执行。
2、任务的执行(Executor)
如下图所示,包括任务执行机制的核心接口 Executor ,以及继承自 Executor 接口的 ExecutorService 接口。ThreadPoolExecutor 和 ScheduledThreadPoolExecutor 这两个关键类实现了 ExecutorService 接口。
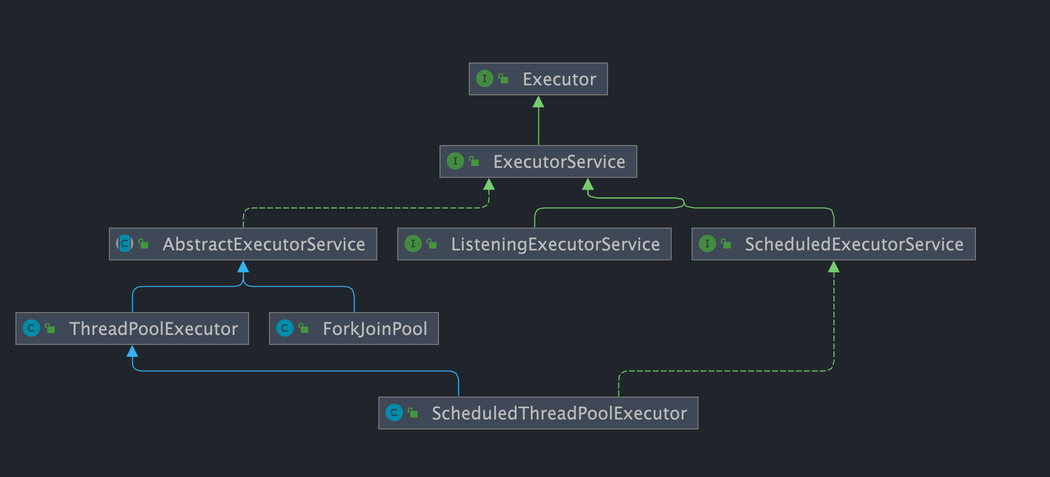
这里提了很多底层的类关系,但是,实际上我们需要更多关注的是 ThreadPoolExecutor 这个类,这个类在我们实际使用线程池的过程中,使用频率还是非常高的。
注意: 通过查看 ScheduledThreadPoolExecutor 源代码我们发现 ScheduledThreadPoolExecutor 实际上是继承了 ThreadPoolExecutor 并实现了 ScheduledExecutorService ,而 ScheduledExecutorService 又实现了 ExecutorService,正如我们上面给出的类关系图显示的一样。
ThreadPoolExecutor 类描述:
//AbstractExecutorService实现了ExecutorService接口
public class ThreadPoolExecutor extends AbstractExecutorService
ScheduledThreadPoolExecutor 类描述:
//ScheduledExecutorService继承ExecutorService接口
public class ScheduledThreadPoolExecutor
        extends ThreadPoolExecutor
implements ScheduledExecutorService3、异步计算的结果(Future)
Future 接口以及 Future 接口的实现类 FutureTask 类都可以代表异步计算的结果。
当我们把 Runnable接口 或 Callable 接口 的实现类提交给 ThreadPoolExecutor 或 ScheduledThreadPoolExecutor 执行。(调用 submit() 方法时会返回一个 FutureTask 对象)
Executor 框架的使用示意图:
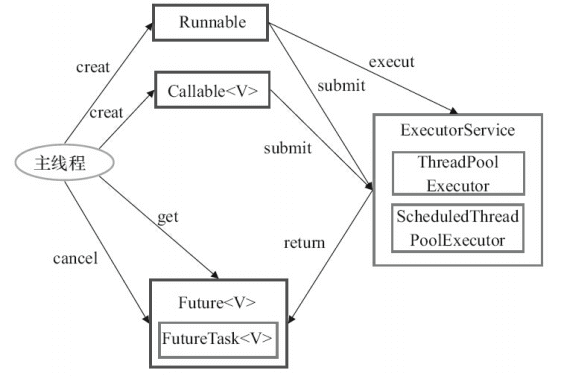
主线程首先要创建实现
Runnable或者Callable接口的任务对象。把创建完成的实现
Runnable/Callable接口的 对象直接交给ExecutorService执行:ExecutorService.execute(Runnable command))或者也可以把Runnable对象或Callable对象提交给ExecutorService执行(ExecutorService.submit(Runnable task)或ExecutorService.submit(Callable <T> task))。如果执行
ExecutorService.submit(…),ExecutorService将返回一个实现Future接口的对象(我们刚刚也提到过了执行execute()方法和submit()方法的区别,submit()会返回一个FutureTask 对象)。由于 FutureTask实现了Runnable,我们也可以创建FutureTask,然后直接交给ExecutorService执行。最后,主线程可以执行
FutureTask.get()方法来等待任务执行完成。主线程也可以执行FutureTask.cancel(boolean mayInterruptIfRunning)来取消此任务的执行。
⭐️ 三、ThreadPoolExecutor 类介绍
线程池实现类 ThreadPoolExecutor 是 Executor 框架最核心的类。
1、线程池参数分析
ThreadPoolExecutor 类中提供的四个构造方法。我们来看最长的那个,其余三个都是在这个构造方法的基础上产生(其他几个构造方法说白点都是给定某些默认参数的构造方法比如默认制定拒绝策略是什么)。
    /**
     * 用给定的初始参数创建一个新的ThreadPoolExecutor。
     */
    public ThreadPoolExecutor(int corePoolSize,//线程池的核心线程数量
                              int maximumPoolSize,//线程池的最大线程数
                              long keepAliveTime,//当线程数大于核心线程数时,多余的空闲线程存活的最长时间
                              TimeUnit unit,//时间单位
                              BlockingQueue<Runnable> workQueue,//任务队列,用来储存等待执行任务的队列
                              ThreadFactory threadFactory,//线程工厂,用来创建线程,一般默认即可
                              RejectedExecutionHandler handler//拒绝策略,当提交的任务过多而不能及时处理时,我们可以定制策略来处理任务
                               ) {
        if (corePoolSize < 0 ||
            maximumPoolSize <= 0 ||
            maximumPoolSize < corePoolSize ||
            keepAliveTime < 0)
            throw new IllegalArgumentException();
        if (workQueue == null || threadFactory == null || handler == null)
            throw new NullPointerException();
        this.corePoolSize = corePoolSize;
        this.maximumPoolSize = maximumPoolSize;
        this.workQueue = workQueue;
        this.keepAliveTime = unit.toNanos(keepAliveTime);
        this.threadFactory = threadFactory;
        this.handler = handler;
    }
下面这些参数非常重要,在后面使用线程池的过程中你一定会用到!所以,务必拿着小本本记清楚。
ThreadPoolExecutor 3 个最重要的参数:
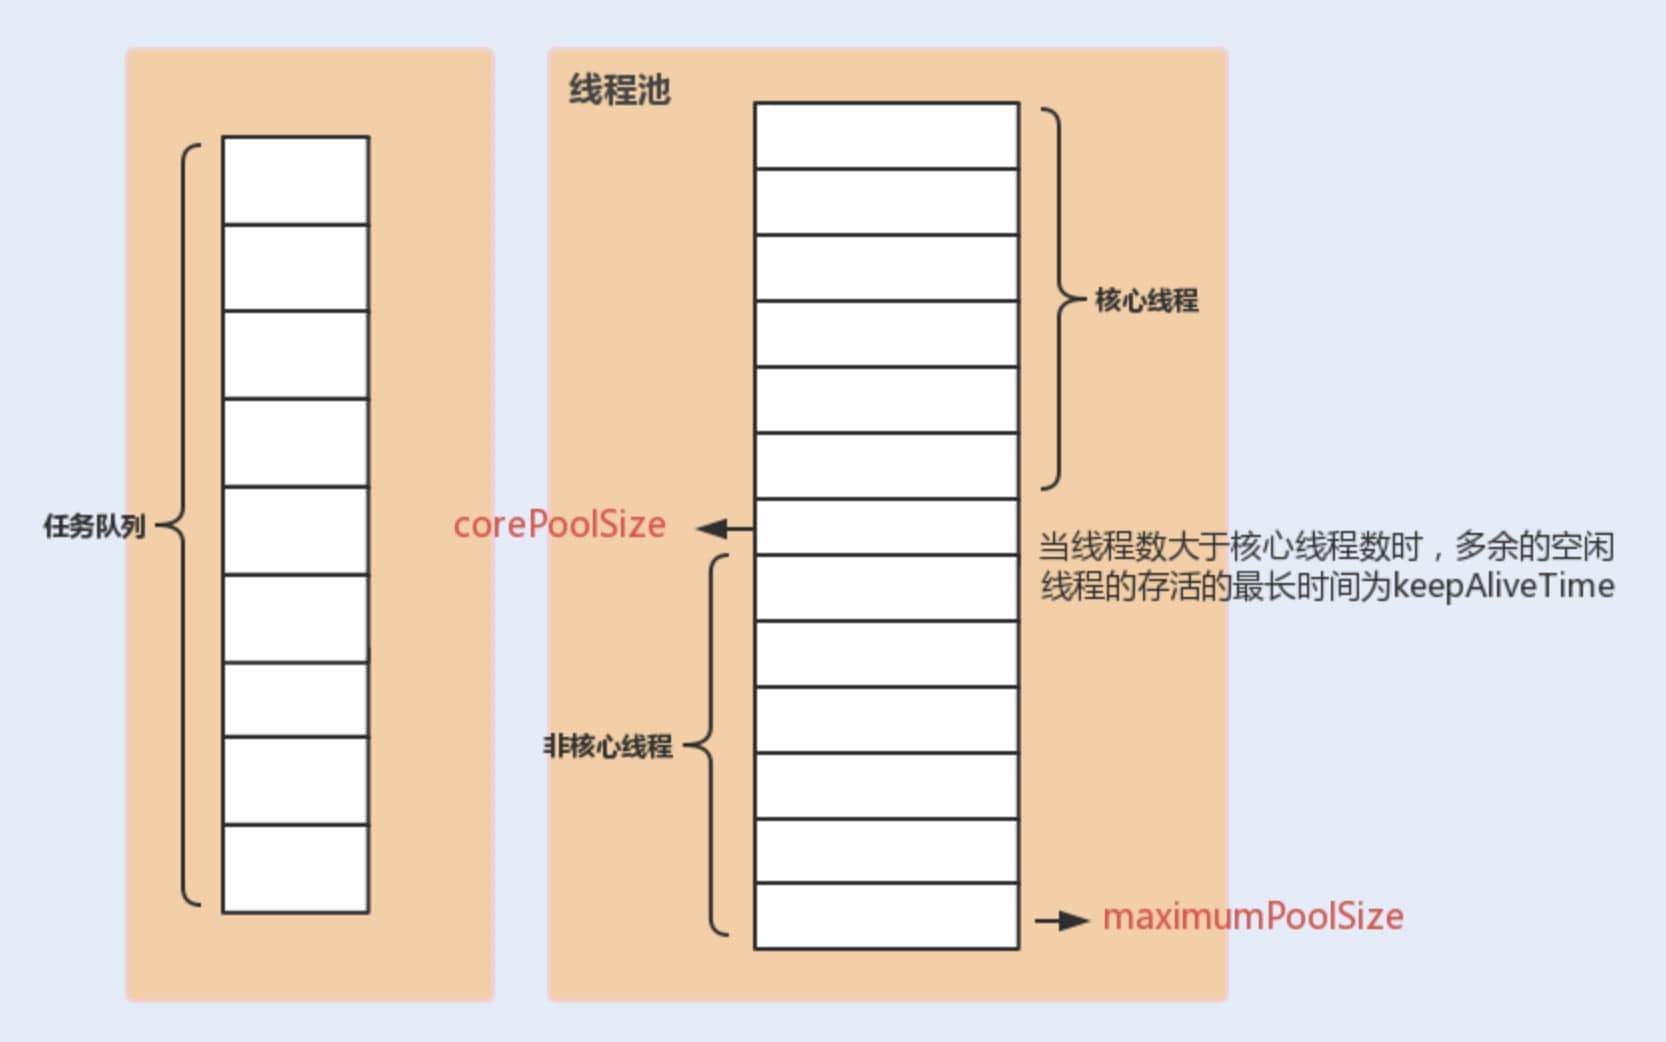
corePoolSize: 任务队列未达到队列容量时,最大可以同时运行的线程数量。maximumPoolSize: 任务队列中存放的任务达到队列容量的时候,当前可以同时运行的线程数量变为最大线程数。workQueue: 新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。
ThreadPoolExecutor其他常见参数 :
keepAliveTime:线程池中的线程数量大于corePoolSize的时候,如果这时没有新的任务提交,核心线程外的线程不会立即销毁,而是会等待,直到等待的时间超过了keepAliveTime才会被回收销毁。unit:keepAliveTime参数的时间单位。threadFactory:executor 创建新线程的时候会用到。handler:拒绝策略(后面会单独详细介绍一下)。
下面这张图可以加深你对线程池中各个参数的相互关系的理解(图片来源:《Java 性能调优实战》):
2、线程池生命周期状态
ThreadPoolExecutor 使用 ctl 变量(AtomicInteger 类型)同时管理线程池的运行状态和工作线程数量。
线程池共有 5 种状态:
- 运行中(
RUNNING):接受新任务,并处理队列中的任务。线程池创建后的初始状态。 - 关闭(
SHUTDOWN):不再接受新任务,但会继续处理队列中已有的任务。调用shutdown()后进入。 - 停止(
STOP):不接受新任务,不处理队列中的任务,并尝试中断正在执行的任务。调用shutdownNow()后进入。 - 整理中(
TIDYING):所有任务已终止,工作线程数为 0,即将执行terminated()钩子方法。 - 已终止(
TERMINATED):terminated()方法执行完毕,线程池彻底终结。
状态只能单向流转:运行中(RUNNING)→ 关闭(SHUTDOWN)→ 整理中(TIDYING)→ 已终止(TERMINATED),或者运行中(RUNNING)→ 停止(STOP)→ 整理中(TIDYING)→ 已终止(TERMINATED)。在关闭(SHUTDOWN)状态下再调用 shutdownNow() 也会转为停止(STOP)。
shutdown() 是"温和关闭"——中断空闲线程,但队列中的任务仍会执行完毕。shutdownNow() 是"强制关闭"——尝试中断所有正在运行的线程,并将队列中未执行的任务以 List<Runnable> 返回。terminated() 是一个空的钩子方法,可以通过继承 ThreadPoolExecutor 来重写它,用于在线程池终止后做清理工作。
3、Worker 工作线程机制
ThreadPoolExecutor 将每个工作线程封装为内部类 Worker。Worker 继承了 AQS 并实现了 Runnable 接口。
为什么 Worker 要继承 AQS?
Worker 实现了一个不可重入的独占锁,用于配合 shutdown() 区分线程是空闲还是正在工作——正在执行任务的 Worker 持有锁,shutdown() 对每个 Worker 尝试 tryLock(),失败则说明该线程正在工作,不会被中断。
Worker 的生命周期:
- 创建:
execute()判断需要新建线程时,调用addWorker()创建Worker实例,内部通过ThreadFactory创建线程。 - 运行:线程启动后进入
runWorker()的while循环,通过getTask()不断从队列取任务执行。核心线程用workQueue.take()(阻塞等待),非核心线程用workQueue.poll(keepAliveTime, unit)(超时等待)。 - 退出:
getTask()返回null时 Worker 退出循环并清理。返回null的情况包括:线程池处于停止(STOP)状态、线程池处于关闭(SHUTDOWN)状态且队列为空、非核心线程等待超时、或运行时缩小了maximumPoolSize。如果退出后工作线程数低于核心数,会自动补充一个新线程。
4、拒绝策略定义
如果当前同时运行的线程数量达到最大线程数量,并且队列也已经被放满了任务时(线程和队列都没空),ThreadPoolExecutor 定义一些策略:
ThreadPoolExecutor.AbortPolicy:抛出RejectedExecutionException来拒绝新任务的处理。📌 场景案例:订单系统
javaexecutor.execute(() -> createOrder());当系统已经满载,直接报错:
RejectedExecutionException💥 影响
- 调用方必须处理异常
- 否则直接导致接口报错(HTTP 500)
✅ 适用场景
👉 不能丢任务,也不能降级
例如:
- 支付
- 核心交易
- 数据一致性强依赖
ThreadPoolExecutor.CallerRunsPolicy:调用执行者自己的线程运行任务,也就是直接在调用execute方法的线程中运行(run)被拒绝的任务,如果执行程序已关闭,则会丢弃该任务。因此这种策略会降低对于新任务提交速度,影响程序的整体性能。如果你的应用程序可以承受此延迟并且你要求任何一个任务请求都要被执行的话,你可以选择这个策略。📌 场景案例:日志系统
javaexecutor.execute(() -> writeLog());线程池满了之后,当前线程(比如 main / Tomcat 线程)执行:
main线程开始写日志...💡 核心效果:反压(Back Pressure):调用者在此期间无法提交新任务,形成了一种天然的**反压(back-pressure)**机制
因为:👉 提交任务的线程被“拖慢了”
🔥 实际效果
原来 现在 线程池处理 调用方处理 快速提交 被阻塞变慢 ✅ 适用场景
- 不允许丢任务
- 可以接受变慢
例如:
- 日志系统
- 异步落库(但不能丢)
❗ 注意坑
如果你在 Web 服务中用:
👉 会拖慢请求线程(比如 Tomcat)
ThreadPoolExecutor.DiscardPolicy:不处理新任务,直接丢弃掉。📌 场景案例:埋点统计
javaexecutor.execute(() -> sendMetric());线程池满:👉 任务直接消失(无日志、无异常)
💥 风险
👉 数据直接丢失且你不知道
✅ 适用场景
- 允许丢数据
- 非核心业务
例如:
- 用户行为埋点
- 推荐系统曝光统计
ThreadPoolExecutor.DiscardOldestPolicy:此策略将丢弃最早的未处理的任务请求。📌 场景案例:实时数据处理
队列中任务:
[任务A, 任务B]新任务 C 来了(线程池满):
👉 执行:
java丢弃 A 队列变成 [任务B] 加入 C → [任务B, 任务C]💡 本质
👉 保新不保旧
✅ 适用场景
- 更关心“最新数据”
例如:
- 实时监控
- UI刷新任务
- 股票行情推送
❗ 注意坑
👉 被丢弃的任务完全不会执行
⚖️ 四种策略对比总结
| 策略 | 是否丢任务 | 是否报错 | 特点 |
|---|---|---|---|
| AbortPolicy | ❌ | ✅ | 强制失败 |
| CallerRunsPolicy | ❌ | ❌ | 降速执行 |
| DiscardPolicy | ✅ | ❌ | 静默丢弃 |
| DiscardOldestPolicy | ✅(丢旧) | ❌ | 保新任务 |
🧠 真实生产怎么选?
👉 一般建议:
| 场景 | 推荐策略 |
|---|---|
| 核心业务 | AbortPolicy |
| 日志/异步 | CallerRunsPolicy |
| 埋点/统计 | DiscardPolicy |
| 实时系统 | DiscardOldestPolicy |
举个例子:Spring 通过 ThreadPoolTaskExecutor 或者我们直接通过 ThreadPoolExecutor 的构造函数创建线程池的时候,当我们不指定 RejectedExecutionHandler 拒绝策略来配置线程池的时候,默认使用的是 AbortPolicy。在这种拒绝策略下,如果队列满了,ThreadPoolExecutor 将抛出 RejectedExecutionException 异常来拒绝新来的任务 ,这代表你将丢失对这个任务的处理。如果不想丢弃任务的话,可以使用CallerRunsPolicy。CallerRunsPolicy 和其他的几个策略不同,它既不会抛弃任务,也不会抛出异常,而是将任务回退给调用者,使用调用者的线程来执行任务
public static class CallerRunsPolicy implements RejectedExecutionHandler {

        public CallerRunsPolicy() { }

        public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
            if (!e.isShutdown()) {
                // 直接主线程执行,而不是线程池中的线程执行
                r.run();
            }
        }
    }
5、4 种拒绝策略的实际应用场景
上面介绍了 4 种内置拒绝策略的基本行为,下面结合实际生产经验,说明它们各自适合什么场景:
AbortPolicy:适用于对任务丢失零容忍的核心业务(如支付、转账)。任务被拒绝时调用方会收到 RejectedExecutionException,必须在业务代码中捕获并做补偿(如重试或持久化到数据库后补偿执行)。《阿里巴巴 Java 开发手册》指出,如果不做任何配置,队列满时会直接抛异常,开发者必须显式处理。
CallerRunsPolicy:适用于不允许丢弃任务、且允许降低提交速度的场景。由于任务在调用者线程中执行,调用者在此期间无法提交新任务,形成了一种天然的**反压(back-pressure)**机制。美团技术团队在《Java 线程池实现原理及其在美团业务中的实践》中提到,这是他们线上业务中较常使用的拒绝策略。但需要注意:如果提交任务的线程是 Web 容器的请求处理线程(如 Tomcat 的 Worker 线程),会导致该请求响应时间显著增加,在延迟敏感的场景中需谨慎。
DiscardPolicy:适用于任务允许丢失的非关键路径,如日志异步写入、监控指标上报。该策略完全静默(空实现),被拒绝的任务不会留下任何痕迹,排查问题时可能难以发现任务丢失。
DiscardOldestPolicy:适用于只关心最新数据、旧任务可被覆盖的场景,如实时行情推送、传感器数据采集。需要注意:如果使用了 PriorityBlockingQueue,poll() 弹出的是优先级最高的任务而非最旧的任务,可能导致重要任务被误丢。
生产环境中的常见做法:以上 4 种内置策略往往不能完全满足需求。Dubbo 框架自定义了 AbortPolicyWithReport 策略,在抛异常之外还会将被拒绝的任务信息 dump 到本地文件,方便事后排查。美团技术团队建议对线程池的拒绝次数进行监控和告警。常见的自定义策略思路包括:将被拒绝的任务写入数据库或消息队列后续补偿消费、递增监控计数器上报 Prometheus、或者调用 workQueue.put(r) 阻塞等待队列有空位(Netty 中有类似实现)。
🧪测试案例
import java.util.concurrent.*;

public class ThreadPoolRejectDemo {

    public static void main(String[] args) throws InterruptedException {

        testPolicy("AbortPolicy", new ThreadPoolExecutor.AbortPolicy());
        testPolicy("CallerRunsPolicy", new ThreadPoolExecutor.CallerRunsPolicy());
        testPolicy("DiscardPolicy", new ThreadPoolExecutor.DiscardPolicy());
        testPolicy("DiscardOldestPolicy", new ThreadPoolExecutor.DiscardOldestPolicy());
    }

    private static void testPolicy(String name, RejectedExecutionHandler handler) throws InterruptedException {

        System.out.println("\n==============================");
        System.out.println("测试策略: " + name);
        System.out.println("==============================");

        ThreadPoolExecutor executor = new ThreadPoolExecutor(
                2,                      // core
                2,                      // max(故意设置一样,方便触发)
                10,
                TimeUnit.SECONDS,
                new ArrayBlockingQueue<>(2), // 队列容量2
                Executors.defaultThreadFactory(),
                handler
        );

        // 提交 6 个任务(一定会触发拒绝策略)
        for (int i = 1; i <= 6; i++) {
            final int taskId = i;

            try {
                executor.execute(() -> {
                    String threadName = Thread.currentThread().getName();
                    System.out.println("任务 " + taskId + " 执行线程: " + threadName);
                    try {
                        Thread.sleep(2000); // 模拟任务执行耗时
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }
                });
                System.out.println("提交任务 " + taskId + " 成功");
            } catch (Exception e) {
                System.out.println("任务 " + taskId + " 被拒绝: " + e);
            }
        }

        executor.shutdown();
        executor.awaitTermination(10, TimeUnit.SECONDS);
    }
}
🔍一、典型输出(重点解读)
1️⃣ AbortPolicy(默认)
java提交任务 1 成功 提交任务 2 成功 提交任务 3 成功 提交任务 4 成功 任务 5 被拒绝: RejectedExecutionException 任务 6 被拒绝: RejectedExecutionException👉 特点:
- 超出的任务直接抛异常
- 强制失败
2️⃣ CallerRunsPolicy
java提交任务 1 成功 提交任务 2 成功 提交任务 3 成功 提交任务 4 成功 任务 5 执行线程: main 任务 6 执行线程: main👉 特点:
- 被拒绝的任务由 主线程执行
- 明显看到:
main3️⃣ DiscardPolicy
java提交任务 1 成功 提交任务 2 成功 提交任务 3 成功 提交任务 4 成功 提交任务 5 成功 提交任务 6 成功但会发现:👉 任务5、6根本没执行(悄悄丢了)
4️⃣ DiscardOldestPolicy
java提交任务 1 成功 提交任务 2 成功 提交任务 3 成功 提交任务 4 成功 提交任务 5 成功 提交任务 6 成功但执行顺序可能变成:
java任务 3 执行 任务 4 执行 任务 5 执行 任务 6 执行👉 说明:任务1、2 被“踢掉了”
🧠 二、为什么一定会触发拒绝?
配置是关键👇
javacore = 2 max = 2 queue = 2 总容量 = 4但提交:
java6 个任务👉 多出来的 2 个任务 → 必触发拒绝策略
🚀自定义拒绝策略(生产常用)
很多情况不会直接用默认策略,而是自定义:
class MyRejectHandler implements RejectedExecutionHandler {

    @Override
    public void rejectedExecution(Runnable r, ThreadPoolExecutor executor) {
        System.out.println("❗任务被拒绝,记录日志 + 告警");

        // 可以做:
        // 1. 记录日志
        // 2. 写入数据库
        // 3. 发送报警(钉钉/邮件)
        // 4. 降级处理
    }
}
使用:
new ThreadPoolExecutor(
        2, 2, 10, TimeUnit.SECONDS,
        new ArrayBlockingQueue<>(2),
        new MyRejectHandler()
);
🧠 一句话总结
👉 拒绝策略不是“异常情况”,而是线程池“过载保护机制”的核心设计。
6、线程池创建的两种方式
在 Java 中,创建线程池主要有两种方式:
方式一:通过 ThreadPoolExecutor 构造函数直接创建 (推荐)
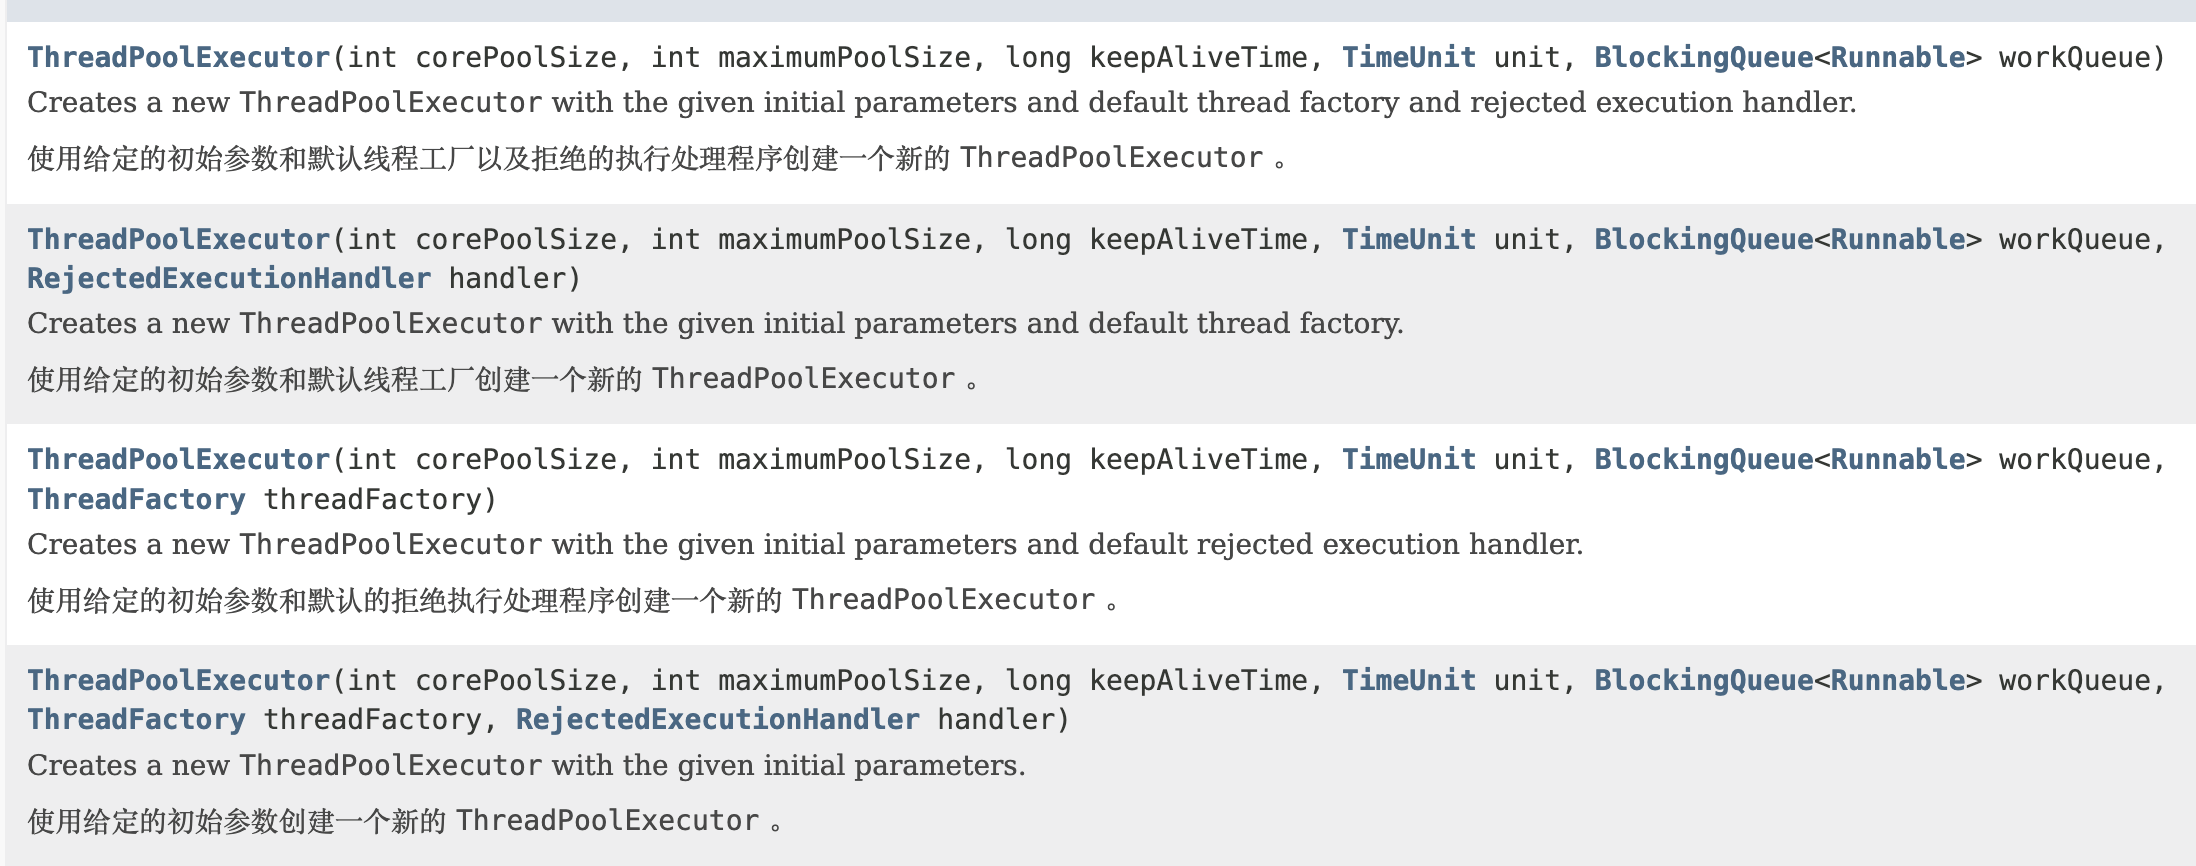 这是最推荐的方式,因为它允许开发者明确指定线程池的核心参数,对线程池的运行行为有更精细的控制,从而避免资源耗尽的风险。
方式二:通过 Executors 工具类创建 (不推荐用于生产环境)
Executors工具类提供的创建线程池的方法如下图所示:
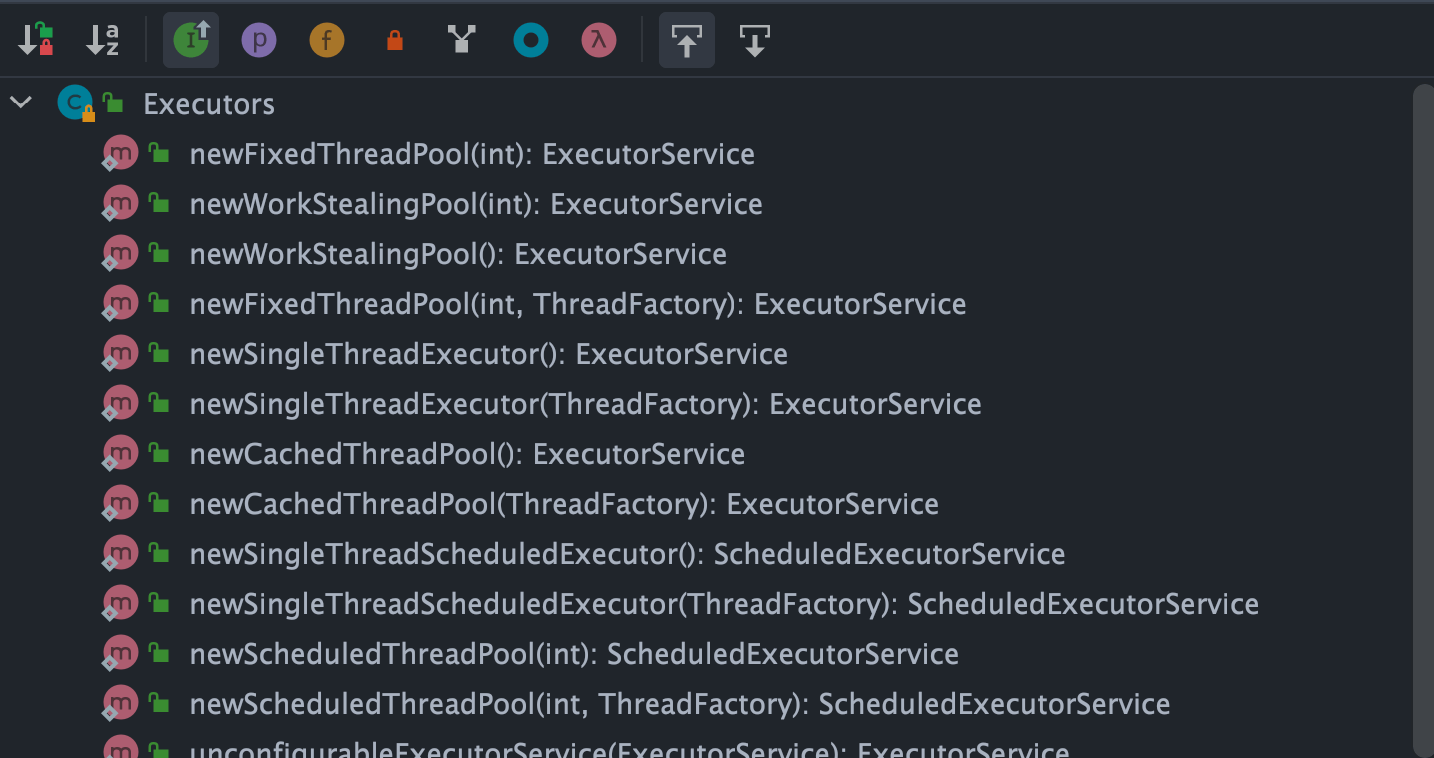
可以看出,通过Executors工具类可以创建多种类型的线程池,包括:
FixedThreadPool:固定线程数量的线程池。该线程池中的线程数量始终不变。当有一个新的任务提交时,线程池中若有空闲线程,则立即执行。若没有,则新的任务会被暂存在一个任务队列中,待有线程空闲时,便处理在任务队列中的任务。SingleThreadExecutor: 只有一个线程的线程池。若多余一个任务被提交到该线程池,任务会被保存在一个任务队列中,待线程空闲,按先入先出的顺序执行队列中的任务。CachedThreadPool: 可根据实际情况调整线程数量的线程池。线程池的线程数量不确定,但若有空闲线程可以复用,则会优先使用可复用的线程。若所有线程均在工作,又有新的任务提交,则会创建新的线程处理任务。所有线程在当前任务执行完毕后,将返回线程池进行复用。ScheduledThreadPool:给定的延迟后运行任务或者定期执行任务的线程池。
《阿里巴巴 Java 开发手册》强制线程池不允许使用 Executors 去创建,而是通过 ThreadPoolExecutor 构造函数的方式,这样的处理方式让写的同学更加明确线程池的运行规则,规避资源耗尽的风险
Executors 返回线程池对象的弊端如下(后文会详细介绍到):
FixedThreadPool和SingleThreadExecutor:使用的是阻塞队列LinkedBlockingQueue,任务队列最大长度为Integer.MAX_VALUE,可以看作是无界的,可能堆积大量的请求,从而导致 OOM。CachedThreadPool:使用的是同步队列SynchronousQueue, 允许创建的线程数量为Integer.MAX_VALUE,如果任务数量过多且执行速度较慢,可能会创建大量的线程,从而导致 OOM。ScheduledThreadPool和SingleThreadScheduledExecutor:使用的无界的延迟阻塞队列DelayedWorkQueue,任务队列最大长度为Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。
public static ExecutorService newFixedThreadPool(int nThreads) {
    // LinkedBlockingQueue 的默认长度为 Integer.MAX_VALUE,可以看作是无界的
    return new ThreadPoolExecutor(nThreads, nThreads,0L, TimeUnit.MILLISECONDS,new LinkedBlockingQueue<Runnable>());

}

public static ExecutorService newSingleThreadExecutor() {
    // LinkedBlockingQueue 的默认长度为 Integer.MAX_VALUE,可以看作是无界的
    return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1,0L, TimeUnit.MILLISECONDS,new LinkedBlockingQueue<Runnable>()));

}

// 同步队列 SynchronousQueue,没有容量,最大线程数是 Integer.MAX_VALUE`
public static ExecutorService newCachedThreadPool() {

    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,60L, TimeUnit.SECONDS,new SynchronousQueue<Runnable>());

}

// DelayedWorkQueue(延迟阻塞队列)
public static ScheduledExecutorService newScheduledThreadPool(int corePoolSize) {
    return new ScheduledThreadPoolExecutor(corePoolSize);
}
public ScheduledThreadPoolExecutor(int corePoolSize) {
    super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS,
          new DelayedWorkQueue());
}
7、线程池常用的阻塞队列总结
新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。
不同的线程池会选用不同的阻塞队列,我们可以结合内置线程池来分析。
- 容量为
Integer.MAX_VALUE的LinkedBlockingQueue(无界队列):FixedThreadPool和SingleThreadExector。FixedThreadPool最多只能创建核心线程数的线程(核心线程数和最大线程数相等),SingleThreadExector只能创建一个线程(核心线程数和最大线程数都是 1),二者的任务队列永远不会被放满。 SynchronousQueue(同步队列):CachedThreadPool。SynchronousQueue没有容量,不存储元素,目的是保证对于提交的任务,如果有空闲线程,则使用空闲线程来处理;否则新建一个线程来处理任务。也就是说,CachedThreadPool的最大线程数是Integer.MAX_VALUE,可以理解为线程数是可以无限扩展的,可能会创建大量线程,从而导致 OOM。DelayedWorkQueue(延迟阻塞队列):ScheduledThreadPool和SingleThreadScheduledExecutor。DelayedWorkQueue的内部元素并不是按照放入的时间排序,而是会按照延迟的时间长短对任务进行排序,内部采用的是“堆”的数据结构,可以保证每次出队的任务都是当前队列中执行时间最靠前的。DelayedWorkQueue添加元素满了之后会自动扩容原来容量的 1/2,即永远不会阻塞,最大扩容可达Integer.MAX_VALUE,所以最多只能创建核心线程数的线程。
| 线程池类型 | 核心线程数(corePoolSize) | 最大线程数(maximumPoolSize) | 使用的阻塞队列 | 队列是否有界 | 队列容量 | 线程扩容特点 | 风险/特点 |
|---|---|---|---|---|---|---|---|
FixedThreadPool | 固定值 | 与核心线程数相同 | LinkedBlockingQueue | 无界 | Integer.MAX_VALUE | 不会扩容线程(线程数固定) | 任务过多时可能导致队列堆积、内存溢出 |
SingleThreadExecutor | 1 | 1 | LinkedBlockingQueue | 无界 | Integer.MAX_VALUE | 永远只有一个线程 | 单线程串行执行,任务积压可能导致 OOM |
CachedThreadPool | 0 | Integer.MAX_VALUE | SynchronousQueue | 无容量 | 0 | 来一个任务就可能创建新线程 | 高并发下可能创建大量线程导致 OOM |
ScheduledThreadPool | 固定值 | Integer.MAX_VALUE(实际通常只用核心线程) | DelayedWorkQueue | 无界 | Integer.MAX_VALUE | 队列不会满,通常不会扩容线程 | 定时任务过多可能导致内存占用过高 |
SingleThreadScheduledExecutor | 1 | Integer.MAX_VALUE(实际通常只用1个线程) | DelayedWorkQueue | 无界 | Integer.MAX_VALUE | 基本不会创建额外线程 | 单线程执行定时任务,任务积压风险高 |
⭐️四、线程池原理分析
我们上面讲解了 Executor框架以及 ThreadPoolExecutor 类,下面让我们实战一下,来通过写一个 ThreadPoolExecutor 的小 Demo 来回顾上面的内容。
1、线程池示例代码
首先创建一个 Runnable 接口的实现类(当然也可以是 Callable 接口,我们后面会介绍两者的区别。)
MyRunnable.java
import java.util.Date;

/**
 * 这是一个简单的Runnable类,需要大约5秒钟来执行其任务。
 * @author shuang.kou
 */
public class MyRunnable implements Runnable {

    private String command;

    public MyRunnable(String s) {
        this.command = s;
    }

    @Override
    public void run() {
        System.out.println(Thread.currentThread().getName() + " Start. Time = " + new Date());
        processCommand();
        System.out.println(Thread.currentThread().getName() + " End. Time = " + new Date());
    }

    private void processCommand() {
        try {
            Thread.sleep(5000);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    }

    @Override
    public String toString() {
        return this.command;
    }
}
编写测试程序,我们这里以阿里巴巴推荐的使用 ThreadPoolExecutor 构造函数自定义参数的方式来创建线程池。
ThreadPoolExecutorDemo.java
import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.ThreadPoolExecutor;
import java.util.concurrent.TimeUnit;

public class ThreadPoolExecutorDemo {

    private static final int CORE_POOL_SIZE = 5;
    private static final int MAX_POOL_SIZE = 10;
    private static final int QUEUE_CAPACITY = 100;
    private static final Long KEEP_ALIVE_TIME = 1L;
    public static void main(String[] args) {

        //使用阿里巴巴推荐的创建线程池的方式
        //通过ThreadPoolExecutor构造函数自定义参数创建
        ThreadPoolExecutor executor = new ThreadPoolExecutor(
                CORE_POOL_SIZE,
                MAX_POOL_SIZE,
                KEEP_ALIVE_TIME,
                TimeUnit.SECONDS,
                new ArrayBlockingQueue<>(QUEUE_CAPACITY),
                new ThreadPoolExecutor.CallerRunsPolicy());

        for (int i = 0; i < 10; i++) {
            //创建WorkerThread对象(WorkerThread类实现了Runnable 接口)
            Runnable worker = new MyRunnable("" + i);
            //执行Runnable
            executor.execute(worker);
        }
        //终止线程池
        executor.shutdown();
        while (!executor.isTerminated()) {
        }
        System.out.println("Finished all threads");
    }
}
可以看到我们上面的代码指定了:
corePoolSize: 核心线程数为 5。maximumPoolSize:最大线程数 10keepAliveTime: 等待时间为 1L。unit: 等待时间的单位为 TimeUnit.SECONDS。workQueue:任务队列为ArrayBlockingQueue,并且容量为 100;handler:拒绝策略为CallerRunsPolicy。
输出结构:
pool-1-thread-3 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-5 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-2 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-1 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-4 Start. Time = Sun Apr 12 11:14:37 CST 2020
pool-1-thread-3 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-4 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-1 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-5 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-1 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-2 End. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-5 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-4 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-3 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-2 Start. Time = Sun Apr 12 11:14:42 CST 2020
pool-1-thread-1 End. Time = Sun Apr 12 11:14:47 CST 2020
pool-1-thread-4 End. Time = Sun Apr 12 11:14:47 CST 2020
pool-1-thread-5 End. Time = Sun Apr 12 11:14:47 CST 2020
pool-1-thread-3 End. Time = Sun Apr 12 11:14:47 CST 2020
pool-1-thread-2 End. Time = Sun Apr 12 11:14:47 CST 2020
Finished all threads  // 任务全部执行完了才会跳出来,因为executor.isTerminated()判断为true了才会跳出while循环,当且仅当调用 shutdown() 方法后,并且所有提交的任务完成后返回为 true
2、线程池原理分析
我们通过前面的代码输出结果可以看出:线程池首先会先执行 5 个任务,然后这些任务有任务被执行完的话,就会去拿新的任务执行。 大家可以先通过上面讲解的内容,分析一下到底是咋回事?(自己独立思考一会)
现在,我们就分析上面的输出内容来简单分析一下线程池原理。
为了搞懂线程池的原理,我们需要首先分析一下 execute方法。 在示例代码中,我们使用 executor.execute(worker)来提交一个任务到线程池中去。
这个方法非常重要,下面我们来看看它的源码:
   // 存放线程池的运行状态 (runState) 和线程池内有效线程的数量 (workerCount)
   private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0));

    private static int workerCountOf(int c) {
        return c & CAPACITY;
    }
    //任务队列
    private final BlockingQueue<Runnable> workQueue;

    public void execute(Runnable command) {
        // 如果任务为null,则抛出异常。
        if (command == null)
            throw new NullPointerException();
        // ctl 中保存的线程池当前的一些状态信息
        int c = ctl.get();

        //  下面会涉及到 3 步 操作
        // 1.首先判断当前线程池中的工作线程总数是否小于 corePoolSize
        // 如果小于的话,通过addWorker(command, true)新建一个线程,并将任务(command)添加到该线程中;然后,启动该线程从而执行任务。
        if (workerCountOf(c) < corePoolSize) {
            if (addWorker(command, true))
                return;
            c = ctl.get();
        }
        // 2.如果当前工作线程总数大于等于 corePoolSize 的时候就会走到这里,表明没有走核心线程的创建分支。
        // 通过 isRunning 方法判断 线程池 状态,线程池 处于 RUNNING 状态并且队列可以加入任务,该任务才会被加入进去
        if (isRunning(c) && workQueue.offer(command)) {
            int recheck = ctl.get();
            // 再次获取线程池状态,如果线程池状态不是 RUNNING 状态就需要从任务队列中移除任务,并尝试判断线程是否全部执行完毕。同时执行拒绝策略。
            if (!isRunning(recheck) && remove(command))
                reject(command);
                // 如果当前工作线程数量为0,新创建一个线程并执行。
            else if (workerCountOf(recheck) == 0)
                addWorker(null, false);
        }
        //3. 通过addWorker(command, false)新建一个线程,并将任务(command)添加到该线程中;然后,启动该线程从而执行任务。
        // 传入 false 代表增加线程时判断当前线程数是否少于 maxPoolSize
        // 如果addWorker(command, false)执行失败,则通过reject()执行相应的拒绝策略的内容。
        else if (!addWorker(command, false))
            reject(command);
    }
这里简单分析一下整个流程(对整个逻辑进行了简化,方便理解):
- 如果当前工作线程总数小于核心线程数,那么就会新建一个线程来执行任务。
- 如果当前工作线程总数已经达到核心线程数,先尝试把任务放入任务队列中等待执行。
- 如果向任务队列投放任务失败(任务队列已经满了),并且当前工作线程总数小于最大线程数,就新建一个非核心线程来执行任务。
- 如果当前工作线程总数已经等同于最大线程数,任务队列也无法继续接收任务,那么当前任务会被拒绝,拒绝策略会调用
RejectedExecutionHandler.rejectedExecution()方法。
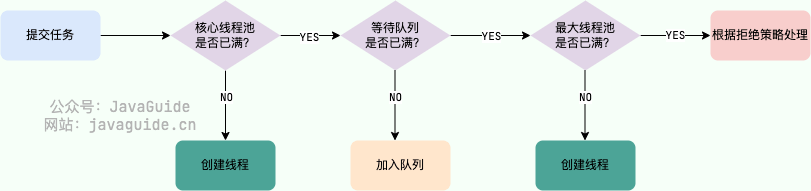
在 execute 方法中,多次调用 addWorker 方法。addWorker 这个方法主要用来创建新的工作线程,如果返回 true 说明创建和启动工作线程成功,否则的话返回的就是 false。
    // 全局锁,并发操作必备
    private final ReentrantLock mainLock = new ReentrantLock();
    // 跟踪线程池的最大大小,只有在持有全局锁mainLock的前提下才能访问此集合
    private int largestPoolSize;
    // 工作线程集合,存放线程池中所有的(活跃的)工作线程,只有在持有全局锁mainLock的前提下才能访问此集合
    private final HashSet<Worker> workers = new HashSet<>();
    //获取线程池状态
    private static int runStateOf(int c)     { return c & ~CAPACITY; }
    //判断线程池的状态是否为 Running
    private static boolean isRunning(int c) {
        return c < SHUTDOWN;
    }


    /**
     * 添加新的工作线程到线程池
     * @param firstTask 要执行
     * @param core参数为true的话表示使用线程池的基本大小,为false使用线程池最大大小
     * @return 添加成功就返回true否则返回false
     */
   private boolean addWorker(Runnable firstTask, boolean core) {
        retry:
        for (;;) {
            //这两句用来获取线程池的状态
            int c = ctl.get();
            int rs = runStateOf(c);

            // Check if queue empty only if necessary.
            if (rs >= SHUTDOWN &&
                ! (rs == SHUTDOWN &&
                   firstTask == null &&
                   ! workQueue.isEmpty()))
                return false;

            for (;;) {
               //获取线程池中工作的线程的数量
                int wc = workerCountOf(c);
                // core参数为false的话表明队列也满了,线程池大小变为 maximumPoolSize
                if (wc >= CAPACITY ||
                    wc >= (core ? corePoolSize : maximumPoolSize))
                    return false;
               //原子操作将workcount的数量加1
                if (compareAndIncrementWorkerCount(c))
                    break retry;
                // 如果线程的状态改变了就再次执行上述操作
                c = ctl.get();
                if (runStateOf(c) != rs)
                    continue retry;
                // else CAS failed due to workerCount change; retry inner loop
            }
        }
        // 标记工作线程是否启动成功
        boolean workerStarted = false;
        // 标记工作线程是否创建成功
        boolean workerAdded = false;
        Worker w = null;
        try {

            w = new Worker(firstTask);
            final Thread t = w.thread;
            if (t != null) {
              // 加锁
                final ReentrantLock mainLock = this.mainLock;
                mainLock.lock();
                try {
                   //获取线程池状态
                    int rs = runStateOf(ctl.get());
                   //rs < SHUTDOWN 如果线程池状态依然为RUNNING,并且线程的状态是存活的话,就会将工作线程添加到工作线程集合中
                  //(rs=SHUTDOWN && firstTask == null)如果线程池状态小于STOP,也就是RUNNING或者SHUTDOWN状态下,同时传入的任务实例firstTask为null,则需要添加到工作线程集合和启动新的Worker
                   // firstTask == null证明只新建线程而不执行任务
                    if (rs < SHUTDOWN ||
                        (rs == SHUTDOWN && firstTask == null)) {
                        if (t.isAlive()) // precheck that t is startable
                            throw new IllegalThreadStateException();
                        workers.add(w);
                       //更新当前工作线程的最大容量
                        int s = workers.size();
                        if (s > largestPoolSize)
                            largestPoolSize = s;
                      // 工作线程是否启动成功
                        workerAdded = true;
                    }
                } finally {
                    // 释放锁
                    mainLock.unlock();
                }
                //// 如果成功添加工作线程,则调用Worker内部的线程实例t的Thread#start()方法启动真实的线程实例
                if (workerAdded) {
                    t.start();
                  /// 标记线程启动成功
                    workerStarted = true;
                }
            }
        } finally {
           // 线程启动失败,需要从工作线程中移除对应的Worker
            if (! workerStarted)
                addWorkerFailed(w);
        }
        return workerStarted;
    }
更多关于线程池源码分析的内容推荐这篇文章:硬核干货:[4W 字从源码上分析 JUC 线程池 ThreadPoolExecutor 的实现原理](../References\硬核干货:4W字从源码上分析JUC线程池ThreadPoolExecutor的实现原理 - throwable - 博客园.mhtml)。
现在,让我们在回到示例代码, 现在应该是不是很容易就可以搞懂它的原理了呢?
没搞懂的话,也没关系,可以看看我的分析:
我们在代码中模拟了 10 个任务,我们配置的核心线程数为 5、等待队列容量为 100 ,所以每次只可能存在 5 个任务同时执行,剩下的 5 个任务会被放到等待队列中去。当前的 5 个任务中如果有任务被执行完了,线程池就会去拿新的任务执行。
3、几个常见的对比
3.1、Runnable vs Callable
Runnable自 Java 1.0 以来一直存在,但Callable仅在 Java 1.5 中引入,目的就是为了来处理Runnable不支持的用例。Runnable 接口不会返回结果或抛出检查异常,但是 Callable 接口可以。所以,如果任务不需要返回结果或抛出异常推荐使用 Runnable 接口,这样代码看起来会更加简洁。
工具类 Executors 可以实现将 Runnable 对象转换成 Callable 对象。(Executors.callable(Runnable task) 或 Executors.callable(Runnable task, Object result)),其中 result 为指定返回的内容(例如 “success”)。
Runnable.javajava@FunctionalInterface public interface Runnable { /** * 被线程执行,没有返回值也无法抛出异常 */ public abstract void run(); }Callable.javajava@FunctionalInterface public interface Callable<V> { /** * 计算结果,或在无法这样做时抛出异常。 * @return 计算得出的结果 * @throws 如果无法计算结果,则抛出异常 */ V call() throws Exception; }
| 接口 | 是否有返回值 | 是否能抛异常 |
|---|---|---|
Runnable | ❌ 无返回值 | ❌ 不能直接抛 checked 异常 |
Callable | ✅ 有返回值 | ✅ 可以抛异常 |
一、Executors.callable(Runnable task)
这个方法:
Executors.callable(Runnable task)会:
- 执行
Runnable- 返回一个
Callable<Object>call()执行完成后返回:javanull示例代码:
javaimport java.util.concurrent.Callable; import java.util.concurrent.Executors; public class Demo { public static void main(String[] args) throws Exception { Runnable runnable = () -> { System.out.println("执行 Runnable 任务"); }; // Runnable -> Callable Callable<Object> callable = Executors.callable(runnable); // 执行 call() Object result = callable.call(); System.out.println("返回结果:" + result); } }运行结果
javanull二、Executors.callable(Runnable task, Object result)
这个方法:
Executors.callable(Runnable task, result)会:
- 先执行
Runnable- 然后返回指定结果 result
运行结果
正在处理订单...
任务结果:SUCCESS
三、在线程池中的实际使用
线程池:
submit()本质支持:
Runnable
⚠
submit()内部会将Runnable转为Callable,指定的返回结果result为nullCallable
有时系统里只有
Runnable,但你又想:通过 Future 获取结果此时可以转换。
示例:线程池 + callable
javaimport java.util.concurrent.*; public class Demo { public static void main(String[] args) throws Exception { ExecutorService pool = Executors.newFixedThreadPool(2); Runnable runnable = () -> { System.out.println( Thread.currentThread().getName() + " 执行任务" ); }; // 转换 Callable,并指定返回值 Callable<String> callable = Executors.callable(runnable, "任务执行成功"); Future<String> future = pool.submit(callable); // 获取返回结果 String result = future.get(); System.out.println(result); pool.shutdown(); } }运行结果(示例)
javapool-1-thread-1 执行任务 任务执行成功四、源码原理(非常重要)
源码本质:
public static <T> Callable<T> callable(
        Runnable task,
        T result) {

    if (task == null)
        throw new NullPointerException();

    return new RunnableAdapter<T>(task, result);
}
内部包装类:
static final class RunnableAdapter<T>
        implements Callable<T> {

    final Runnable task;
    final T result;

    public T call() {
        task.run();
        return result;
    }
}
所以:
javaRunnable -> Callable 本质是适配器模式五、实际开发中的意义
最常见用途:
场景 用法 给 Runnable 增加返回值 Executors.callable(r, result)老系统兼容 Callable API 包装 Runnable CompletionService 使用 转 Callable invokeAll 批量任务 转 Callable
3.2、execute() vs submit()
execute() 和 submit()是两种提交任务到线程池的方法,有一些区别:
- 返回值:
execute()方法用于提交不需要返回值的任务。通常用于执行Runnable任务,无法判断任务是否被线程池成功执行。submit()方法用于提交需要返回值的任务。可以提交Runnable或Callable任务。submit()方法返回一个Future对象,通过这个Future对象可以判断任务是否执行成功,并获取任务的返回值(get()方法会阻塞当前线程直到任务完成,get(long timeout,TimeUnit unit)多了一个超时时间,如果在timeout时间内任务还没有执行完,就会抛出java.util.concurrent.TimeoutException)。 - 异常处理:在使用
submit()方法时,可以通过Future对象处理任务执行过程中抛出的异常;而在使用execute()方法时,异常处理需要通过自定义的ThreadFactory(在线程工厂创建线程的时候设置UncaughtExceptionHandler对象来 处理异常)或ThreadPoolExecutor的afterExecute()方法来处理。
| 方法 | 是否能获取结果 | 异常传播方式 |
|---|---|---|
execute() | ❌ 不返回结果 | 异常直接抛给工作线程 |
submit() | ✅ 返回 Future | 异常会被包装到 Future 中 |
一、二者返回值对比
示例 1:使用
get()方法获取返回值。java// 这里只是为了演示使用,推荐使用 `ThreadPoolExecutor` 构造方法来创建线程池。 ExecutorService executorService = Executors.newFixedThreadPool(3); Future<String> submit = executorService.submit(() -> { try { Thread.sleep(5000L); } catch (InterruptedException e) { e.printStackTrace(); } return "abc"; }); String s = submit.get(); System.out.println(s); executorService.shutdown();输出:
plainabc示例 2:使用
get(long timeout,TimeUnit unit)方法获取返回值。javaExecutorService executorService = Executors.newFixedThreadPool(3); Future<String> submit = executorService.submit(() -> { try { Thread.sleep(5000L); } catch (InterruptedException e) { e.printStackTrace(); } return "abc"; }); String s = submit.get(3, TimeUnit.SECONDS); System.out.println(s); executorService.shutdown();输出:
javaException in thread "main" java.util.concurrent.TimeoutException at java.util.concurrent.FutureTask.get(FutureTask.java:205)二、二者异常处理对比
1、submit() 的异常处理
使用
submit()时:任务异常不会直接打印,而是被 FutureTask 捕获,最终future.get()时再抛出:ExecutionException2、submit() 示例
示例代码
import java.util.concurrent.*;

public class SubmitDemo {

    public static void main(String[] args) {

        ExecutorService pool =
                Executors.newFixedThreadPool(1);

        Future<Integer> future = pool.submit(() -> {

            System.out.println("任务开始执行");

            int x = 1 / 0;

            return x;
        });

        try {

            Integer result = future.get();

            System.out.println(result);

        } catch (InterruptedException e) {

            e.printStackTrace();

        } catch (ExecutionException e) {

            System.out.println("捕获任务异常");

            System.out.println(e.getCause());
        }

        pool.shutdown();
    }
}
运行结果
java任务开始执行 捕获任务异常 java.lang.ArithmeticException: / by zero3、submit() 为什么异常不会直接打印?
因为
submit()内部会把任务包装成:FutureTask。源码核心:
javapublic void run() { try { result = callable.call(); } catch (Throwable ex) { setException(ex); } }异常被吃掉并保存,因此线程不会崩,控制台默认不打印异常
4、execute() 的异常处理
execute()不会包装 FutureTask,因此异常会直接抛到工作线程,异常会直接抛到工作线程,控制台直接打印异常堆栈5、execute() 示例
javaimport java.util.concurrent.*; public class ExecuteDemo { public static void main(String[] args) { ExecutorService pool = Executors.newFixedThreadPool(1); pool.execute(() -> { System.out.println("execute 执行"); int x = 1 / 0; }); pool.shutdown(); } }运行结果
javaexecute 执行 Exception in thread "pool-1-thread-1" java.lang.ArithmeticException: / by zero6、execute() 如何统一处理异常?
方式 推荐度 UncaughtExceptionHandler常用 afterExecute()更强大 7、方式1:ThreadFactory + UncaughtExceptionHandler
原理:线程发生未捕获异常时,JVM 会回调:
UncaughtExceptionHandler示例代码
javaimport java.util.concurrent.*; public class ExecuteExceptionDemo { public static void main(String[] args) { ThreadFactory factory = r -> { Thread thread = new Thread(r); // 设置异常处理器 thread.setUncaughtExceptionHandler( (t, e) -> { System.out.println( "线程:" + t.getName() ); System.out.println( "捕获异常:" + e ); }); return thread; }; ExecutorService pool = new ThreadPoolExecutor( 1, 1, 0, TimeUnit.SECONDS, new LinkedBlockingQueue<>(), factory ); pool.execute(() -> { System.out.println("任务开始"); int x = 1 / 0; }); pool.shutdown(); } }运行结果
java任务开始 线程:Thread-0 捕获异常:java.lang.ArithmeticException: / by zero8、方式2:ThreadPoolExecutor.afterExecute()
这是 线程池级别 的统一异常处理。
很多中间件:
- Tomcat
- Dubbo
- Netty
都会类似处理。
javaimport java.util.concurrent.*; public class AfterExecuteDemo { public static void main(String[] args) { ThreadPoolExecutor pool = new ThreadPoolExecutor( 1, 1, 0, TimeUnit.SECONDS, new LinkedBlockingQueue<>() ) { @Override protected void afterExecute( Runnable r, Throwable t) { super.afterExecute(r, t); // execute() 抛出的异常 if (t != null) { System.out.println( "afterExecute 捕获异常:" + t ); } } }; pool.execute(() -> { System.out.println("execute 执行"); int x = 1 / 0; }); pool.shutdown(); } }运行结果
javaexecute 执行 afterExecute 捕获异常: java.lang.ArithmeticException: / by zero